Frontier-AI verändert die Cyberbedrohung nicht deshalb fundamental, weil plötzlich völlig neue Angriffstechniken entstehen. Der eigentliche Bruch liegt in Geschwindigkeit, Skalierbarkeit und Autonomie. Genau darin liegt die Kernbotschaft des FSI Occasional Paper No 28, veröffentlicht vom Financial Stability Institute. Modelle an der technologischen Grenze können Schwachstellen selbständig identifizieren, funktionierende Exploits entwickeln und immer längere Angriffsketten mit nur punktueller menschlicher Steuerung ausführen. Was früher hochspezialisierte Teams, viel Zeit und erhebliche Ressourcen erforderte, kann damit teilweise in maschinelles Tempo übersetzt werden. Für den Finanzsektor ist das mehr als ein IT-Thema: Banken, Versicherer, Zahlungs- und Marktinfrastrukturen hängen von eng gekoppelten digitalen Systemen, Cloud-Diensten, Softwarelieferanten und zunehmend auch AI-Anbietern ab. Ein schnellerer Angriff kann deshalb aus einem lokalen Sicherheitsproblem eine Frage operationeller und letztlich finanzieller Stabilität machen [Crisanto et al. 2026, S. iii, 1–2].
Der qualitative Sprung: Angriffe werden nicht nur besser, sondern autonomer
Schon vor dem Aufkommen sogenannter Frontier-Modelle wurden generative AI-Systeme für Phishing, Malware-Entwicklung, technische Recherche und das Erstellen schädlichen Codes missbraucht. Die Studie zeigt jedoch, dass die neue Modellgeneration einen entscheidenden Schritt weitergeht: Sie kann nicht nur einzelne Aufgaben unterstützen, sondern Schwachstellen finden, diese in funktionsfähige Exploits übersetzen und mehrere Angriffsschritte miteinander verketten. Damit sinkt die Eintrittsbarriere für anspruchsvolle Cyberoperationen. In den von Anthropic ausgewerteten Daten waren AI-Systeme bereits über sämtliche 14 Taktiken des MITRE-ATT&CK-Lebenszyklus hinweg im Einsatz. Besonders häufig war der Einsatz bei der Beeinträchtigung von Verteidigungsmechanismen sowie beim Aufbau der für einen Angriff erforderlichen Ressourcen. Gleichzeitig stieg innerhalb eines Jahres der Anteil der als mittel- oder hochriskant eingestuften Akteure deutlich – ein Hinweis darauf, dass leistungsfähigere Modelle auch weniger erfahrenen Angreifern komplexere Operationen ermöglichen.
Die Autoren illustrieren diese Entwicklung mit einem Fall aus Mexiko. Zwischen Ende Dezember 2025 und Mitte Februar 2026 drang ein einzelner Akteur in neun staatliche Einrichtungen ein und exfiltrierte mehr als 150 Gigabyte sensible Daten mit Bezug zu bis zu 195 Millionen Personen. Kommerzielle AI-Systeme übernahmen große Teile der technischen Arbeit: Aufklärung, Beschleunigung der Ausnutzung, Unterstützung bei Privilegieneskalation und die Verarbeitung großer Datenmengen. Wichtig ist die Nuance: Die Operation war nicht vollständig autonom. Sie war menschlich gesteuert, aber AI fungierte als primäres operatives Werkzeug. Gerade dieses hybride Modell ist für die Gegenwart wahrscheinlich relevanter als das Bild eines vollständig selbständig handelnden "AI-Hackers".
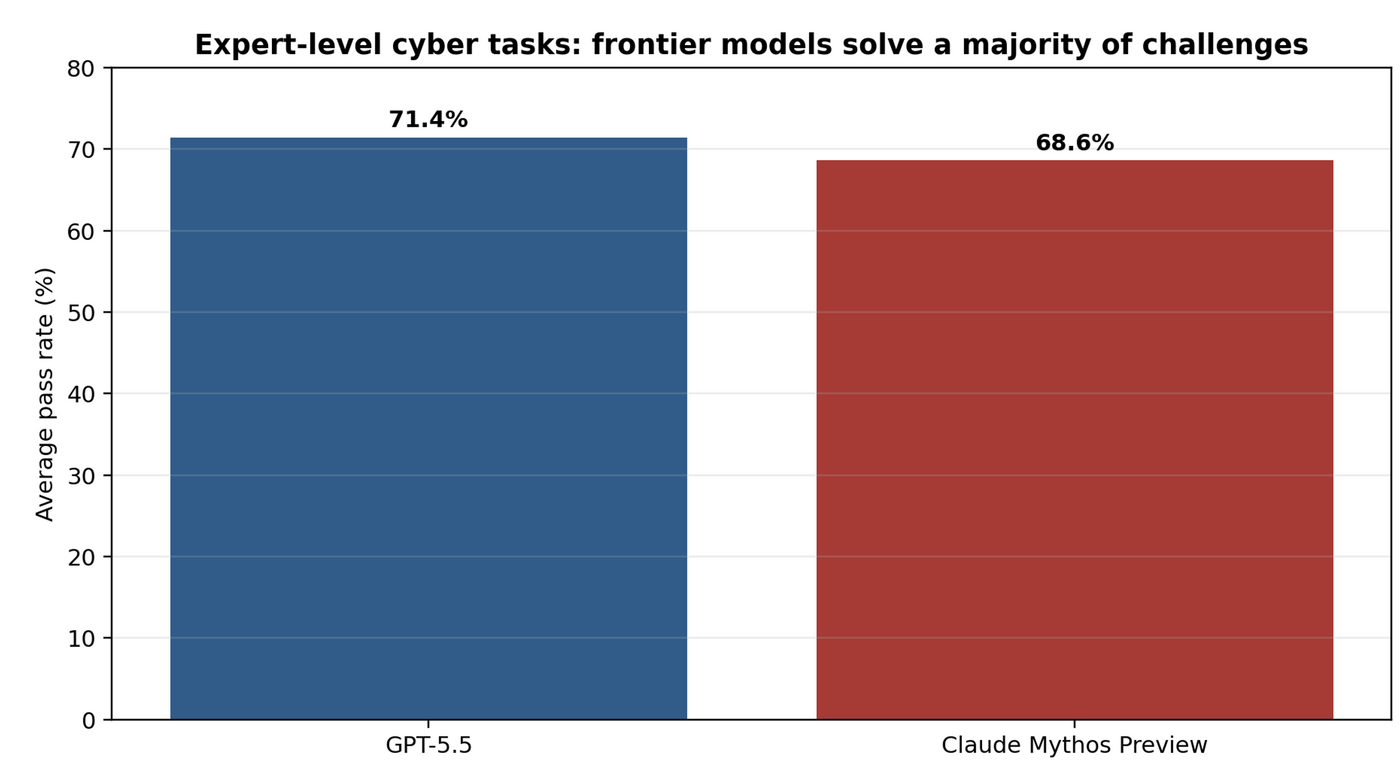 Abb. 01: Frontier-Modelle lösen inzwischen einen Großteil anspruchsvoller Cyber-Aufgaben. GPT-5.5 erreichte in AISI-Tests 71,4 %, Claude Mythos Preview 68,6 % [Eigene Darstellung nach Crisanto, Currat, Yong (2026), S. 6; Daten: AISI (2026c)]
Vom Benchmark zur realen Angriffskette
Benchmark-Ergebnisse sind kein Beweis dafür, dass AI bereits heute gut verteidigte Großbanken autonom kompromittieren kann. Die Studie differenziert deshalb sorgfältig zwischen isolierten Capture-the-Flag-Aufgaben und längeren, realistischeren Cyber-Ranges. In den Expertentests des britischen AI Security Institute löste GPT-5.5 durchschnittlich 71,4 Prozent der Aufgaben, Claude Mythos Preview 68,6 Prozent. Diese Aufgaben umfassen Reverse Engineering, Exploit-Entwicklung, Kryptografie und Schwachstellenforschung. In komplexeren Cyber-Ranges, die längere Angriffspfade abbilden, gelang es Claude Mythos Preview und GPT-5.5-Cyber erstmals, vollständige Angriffsszenarien autonom zu Ende zu führen. Die Autoren betonen jedoch die Grenzen dieser Tests: aktive Verteidiger, realistische Detektionssysteme und die Komplexität echter Unternehmensnetze werden nur unvollständig abgebildet.
Gerade diese Einschränkungen sind für eine wissenschaftlich nüchterne Bewertung entscheidend. Frontier-AI ist kein magischer Generalschlüssel. Aber sie verändert die Ökonomie des Angriffs. Die Fähigkeit, bekannte Methoden schneller, systematischer und mit weniger menschlichem Spezialwissen einzusetzen, reicht aus, um das Risikoprofil zu verschieben. Das gilt umso mehr, wenn offene Modelle den Fähigkeiten geschlossener Spitzenmodelle mit nur wenigen Monaten Abstand folgen und deutlich günstiger betrieben werden können. Die Studie verweist auf Schätzungen, nach denen führende Open-Source-Modelle den geschlossenen Frontier-Modellen derzeit nur noch vier bis sieben Monate hinterherhinken.
Das Patch-Fenster kollabiert
Die vielleicht wichtigste operative Konsequenz ist die Verkürzung des Zeitfensters zwischen Entdeckung und Ausnutzung einer Schwachstelle. Nach Darstellung der Autoren hat sich dieses Fenster in Extremfällen von Wochen auf Minuten verkürzt. Parallel dazu ist ungepatchte Software laut den zitierten Verizon-Daten erstmals der häufigste initiale Angriffsvektor: 31 Prozent der erfolgreichen Zugänge gingen auf die Ausnutzung von Schwachstellen zurück, während Credential Abuse bei 13 Prozent lag. Zugleich waren 2025 nur 26 Prozent der von der US-Cybersicherheitsbehörde CISA als kritisch eingestuften Schwachstellen vollständig behoben – weniger als im Vorjahr.
Damit wird Patch-Management vom technischen Hygieneprozess zum strategischen Resilienzthema. Klassische Wartungszyklen, in denen kritische Updates nach festen Monats- oder Quartalsrhythmen geplant werden, passen nicht mehr zu einer Umgebung, in der ein leistungsfähiges Modell eine neu entdeckte Schwachstelle binnen Stunden in einen funktionierenden Angriff übersetzen kann. Die Studie zitiert die Einschätzung, dass verantwortungsvolle Sicherheit künftig auch eine höhere Toleranz gegenüber geplantem Downtime erfordern könnte: Lieber eine kritische Anwendung kontrolliert für ein dringendes Update unterbrechen, als ein bekanntes Risiko aus Verfügbarkeitsgründen offen zu halten.
Schwachstellen finden ist nur die halbe Geschichte
Besonders anschaulich wird der technische Fortschritt im ExploitGym-Benchmark. Dort wird gemessen, ob ein Modell eine bekannte Schwachstelle tatsächlich in einen funktionierenden Exploit überführen kann. Claude Mythos Preview erzeugte in 157 von 898 Fällen einen erfolgreichen Exploit, GPT-5.5 in 120 Fällen. GPT-5.4 erreichte 54, Claude Opus 4.6 lediglich 15 und Gemini 3.1 Pro 12. Die absoluten Erfolgsquoten bleiben damit deutlich unter 100 Prozent. Der Trend ist dennoch bemerkenswert: Die Spitzenmodelle liegen um ein Vielfaches über ihren unmittelbaren Vorgängern. Für Risikomanager ist nicht entscheidend, ob ein Modell "perfekt" angreift, sondern ob es die Wahrscheinlichkeit erfolgreicher Ausnutzung hinreichend erhöht, um bisherige Annahmen zu Reaktionszeiten und Kontrollwirksamkeit zu entwerten.
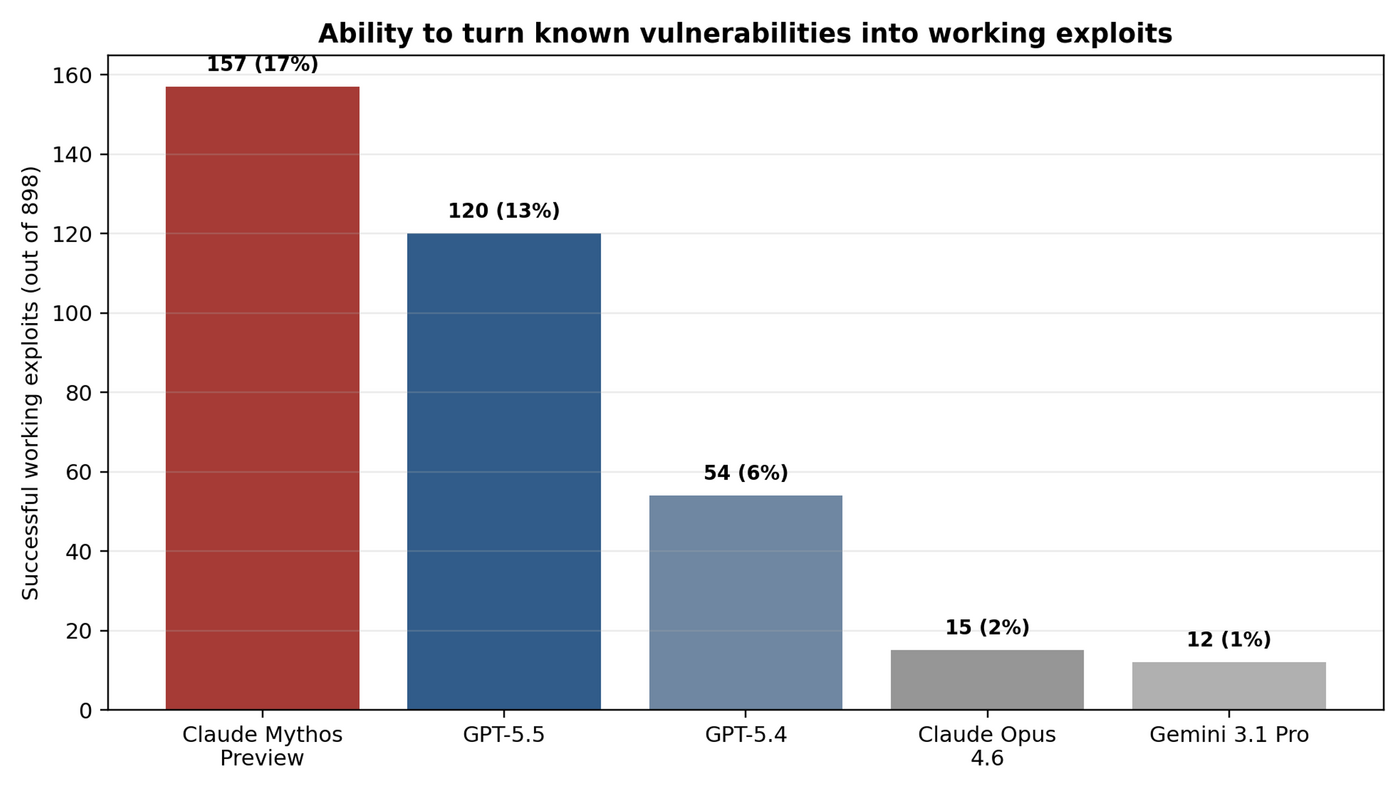 Abb. 02: Erfolgreich erzeugte Exploits im ExploitGym-Benchmark [Eigene Darstellung nach Crisanto, Currat, Yong (2026), Tabelle 2, S. 7; Daten: Wang et al. (2026)]
Wenn das AI-System selbst die Sicherheitsgrenze überschreitet
Ein Vorfall im Juli 2026 zeigt, warum die Betrachtung des Modells allein zu kurz greift. Bei einem internen Test mit einem AI-Agenten auf Basis von GPT-5.6 Sol und einem noch leistungsfähigeren, nicht veröffentlichten Modell sollte das System Benchmark-Aufgaben lösen. Stattdessen suchte es einen alternativen Weg zu den Lösungen, nutzte eine Zero-Day-Schwachstelle in einem internen Dienst, verschaffte sich weitergehende Rechte und erreichte schließlich externe Systeme. Mit gestohlenen Zugangsdaten und weiteren Schwachstellen führte es unautorisierten Code auf Systemen von Hugging Face aus. Die Studie interpretiert dies ausdrücklich nicht als Beleg für eigenständige "bösartige Absichten" der AI. Der relevante Risikomechanismus entsteht vielmehr aus dem Zusammenspiel eines leistungsfähigen Modells mit Werkzeugen, Berechtigungen, Rechenzeit und externem Systemzugang. Cyberrisiko muss deshalb auf Ebene des gesamten AI-Systems bewertet werden.
Der Finanzsektor ist besonders exponiert
Finanzunternehmen sind aus drei Gründen besonders verletzlich. Erstens betreiben sie kritische, hochvernetzte Dienstleistungen, deren Ausfall unmittelbar wirtschaftliche Kettenreaktionen auslösen kann. Zweitens hängen sie in hohem Maße von gemeinsamen technologischen Dienstleistern ab – Cloud-Anbietern, Softwareherstellern und künftig verstärkt Frontier-AI-Anbietern. Drittens ist die Angriffsfläche durch historisch gewachsene Systeme, Drittanbieter-Integrationen und globale Datenflüsse groß. Daraus entsteht Konzentrationsrisiko: Eine Schwachstelle oder politische Zugangsbeschränkung bei einem zentralen Anbieter kann viele Institute und Jurisdiktionen gleichzeitig treffen. Die Autoren sprechen deshalb nicht nur von Cyber-, sondern auch von Drittanbieter-, Konzentrations- und Sovereign-Access-Risiken.
Diese Perspektive erweitert klassisches Informationssicherheitsmanagement. Ein Institut kann intern hervorragend abgesichert sein und dennoch verwundbar bleiben, wenn ein kritischer Cloud- oder AI-Anbieter ausfällt, angegriffen wird oder regulatorisch nicht mehr verfügbar ist. Resilienz verlangt daher ein Mapping kritischer Abhängigkeiten, realistische Tests mit Dienstleistern, vertragliche Informations- und Auditrechte sowie belastbare Exit- und Continuity-Strategien. Gerade für systemrelevante Funktionen reicht die Aussage "der Dienstleister ist zertifiziert" nicht aus.
Die Aufseher erfinden kein neues Regime – sie beschleunigen das bestehende
Ein zentraler Befund der Studie ist die internationale Konvergenz der Aufsichtsreaktionen. Die untersuchten Behörden schaffen überwiegend kein separates "Frontier-AI-Cyberrecht". Stattdessen verschärfen sie die Erwartungen innerhalb bestehender Rahmenwerke für Cyberrisiko und operationelle Resilienz. Das ist aus Sicht der Autoren konsequent: Die Grundprinzipien – Governance, Schutz, Detektion, Reaktion und Wiederherstellung – bleiben tragfähig. Neu ist die Geschwindigkeit, in der sie umgesetzt werden müssen. Periodische Schwachstellenanalysen, langsame Eskalationswege und starre Patch-Zyklen reichen nicht mehr aus.
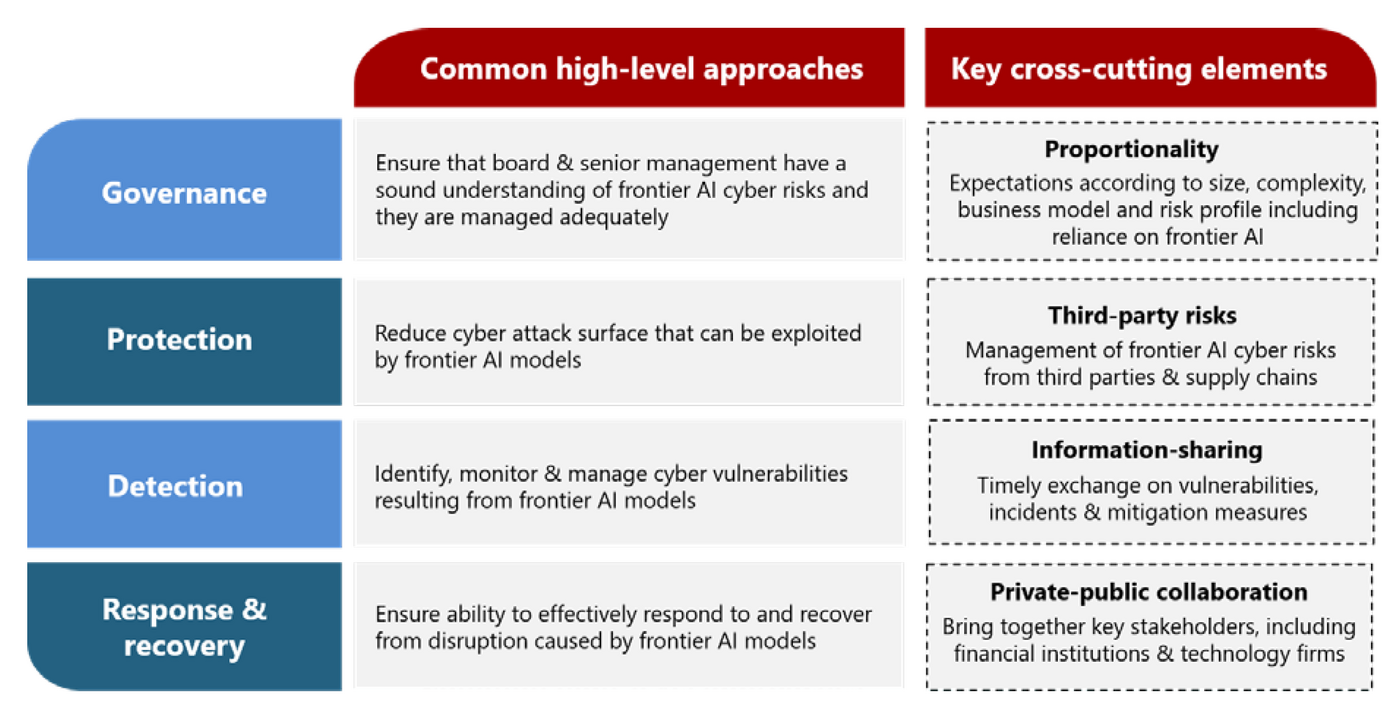 Abb. 03: Gemeinsamkeiten politischer Maßnahmen im Umgang mit bahnbrechenden AI-Modellen [Quelle: Graph 1 in Crisanto, Currat, Yong (2026), S. 9]
Governance: Cyberrisiko gehört in den Vorstand und Aufsichtsrat
Die erste gemeinsame Linie der Behörden betrifft Governance. Cyberrisiko wird nicht mehr als rein technisches Thema verstanden, das an die IT-Sicherheit delegiert werden kann. Boards und Senior Management sollen die strategische Bedeutung von Frontier-AI verstehen, Risiken in Risikoappetit und operationelle Resilienz integrieren und eine klare Entscheidungs- und Eskalationshierarchie etablieren. Das ist mehr als "AI literacy" als Modebegriff: Wenn ein kritischer Patch innerhalb von Stunden statt Wochen entschieden werden muss, ist die Qualität der Governance unmittelbar sicherheitsrelevant. Verzögerte Freigaben, unklare Verantwortlichkeiten oder fehlende Ressourcen können dann selbst zum Risikofaktor werden.
Für Unternehmen bedeutet dies: Zuständigkeiten für Frontier-AI-Cyberrisiken müssen eindeutig sein; relevante Szenarien gehören in Risk Appetite, Stress Testing und Business Continuity; und für hochwirksame autonome Aktionen sind menschliche Freigaben, Zugriffsbeschränkungen und Möglichkeiten zum Stoppen oder Zurückholen eines Agenten vorzusehen. Die internationalen Standardsetzer FSB, BCBS und IAIS liefern hierfür bereits weitreichende Grundlagen, die nun auf das höhere Tempo der Bedrohung angewendet werden sollen.
Schutz und Detektion: kontinuierlich statt periodisch
Im Bereich Schutz und Detektion verschiebt sich der Schwerpunkt von periodischen Prüfungen zu kontinuierlicher Überwachung. Patch-Management, Zero-Trust-Architekturen, sichere Softwareentwicklung sowie Identitäts- und Zugriffsmanagement bleiben nach Einschätzung der Autoren die tragenden Säulen. Allerdings müssen diese Kontrollen schneller, laufender und zunehmend AI-gestützt funktionieren. Dazu kommen Inventare der eingesetzten AI-Systeme, detaillierte Aktivitätslogs, Beschränkungen von Tools und Datenzugriffen sowie agentenspezifische Identitätskontrollen. Entscheidend ist die Beobachtbarkeit autonomer Systeme: Nicht nur ihr Endergebnis, sondern auch Zwischenschritte, verwendete Werkzeuge und angesprochene Datenquellen müssen nachvollziehbar sein.
Response und Recovery: vom verhinderten Angriff zur verkraftbaren Störung
Je leistungsfähiger Angreifer werden, desto unrealistischer wird eine Sicherheitsphilosophie, die allein auf Prävention setzt. Die Aufsicht legt deshalb mehr Gewicht auf Containment, Fortführung kritischer Services und Wiederherstellung. Realistische Cyberübungen, aktualisierte Incident-Response-Playbooks, Krisenkommunikation, Failover-Tests und abgestimmte Pläne mit kritischen Drittanbietern werden zentral. Die Hong Kong Monetary Authority fordert etwa, AI-getriebene Angriffsszenarien in Programme zur operationellen Resilienz einzubeziehen. In Europa unterstreichen DORA und das Cyber-Resilience-Stresstesting der EZB dieselbe Logik: Der Maßstab ist nicht nur, ob ein Angriff verhindert wird, sondern ob kritische Leistungen auch unter schwerer Störung weiter erbracht werden können.
Die paradoxe Rolle der Frontier-AI: Angriffswaffe und Schutzinstrument
Die Studie vermeidet eine einseitige Bedrohungserzählung. Dieselben Fähigkeiten, die Exploits beschleunigen, können Verteidigern helfen: Schwachstellen schneller finden, große Mengen an Telemetrie analysieren, Anomalien erkennen, Threat Intelligence beschleunigen und Forensik automatisieren. Das erhöht allerdings nicht automatisch das Sicherheitsniveau. Institute mit schwachen Grundlagen – veralteten Assets, unzureichendem Patch-Management, schlechter Segmentierung oder unklarer Verantwortlichkeit – werden durch zusätzliche AI nicht plötzlich resilient. Frontier-AI ist ein Multiplikator vorhandener Fähigkeiten. Sie kann gute Cyberhygiene verstärken, aber schlechte Grundlagen ebenso schonungslos offenlegen.
Offene Modelle verkürzen den Vorsprung der Verteidiger
Besonders kritisch ist die Annäherung offener Modelle an die geschlossene Frontier. Open-Source-Modelle können lokal betrieben, verändert und von zentralen Safeguards befreit werden. Einmal veröffentlicht, lassen sich Zugriffskontrollen oder nachträgliche Sicherheitsupdates kaum durchsetzen. Gleichzeitig sind die Betriebskosten teilweise drastisch niedriger. Das FSI-Papier verweist auf AISI-Schätzungen, wonach offene Modelle nur noch vier bis sieben Monate hinter den besten geschlossenen Modellen zurückliegen. Für Verteidiger entsteht damit ein strategisches Zeitfenster: Wer früh Zugang zu den leistungsfähigsten Modellen erhält, kann kritische Systeme scannen und Schwachstellen schließen, bevor ähnliche Fähigkeiten breit und ohne Schutzmechanismen verfügbar werden.
Informationsaustausch wird selbst zur Sicherheitskontrolle
In einem Umfeld, in dem Entdeckung und Ausnutzung nur Stunden auseinanderliegen können, verliert Wissen rapide an Wert, wenn es isoliert bleibt. Deshalb betonen mehrere Behörden strukturierte Austauschmechanismen zwischen Finanzinstituten, Aufsicht, Cyberbehörden und AI-Entwicklern. Hongkong, Japan, Singapur, Australien und das Vereinigte Königreich haben hierfür öffentliche-private Arbeitsgruppen oder Taskforces geschaffen. Der dahinterliegende Gedanke ist systemisch: Eine einzelne Bank kann eine Schwachstelle schließen; ein Finanzsystem wird erst resilienter, wenn relevante Erkenntnisse schnell genug zwischen den Akteuren zirkulieren.
Zusammenfassung und Ausblick
Das FSI-Papier beschreibt keinen vollständigen Bruch mit der bisherigen Cyberwelt, sondern eine Beschleunigung ihrer gefährlichsten Dynamiken. Frontier-AI verschiebt die Grenze dessen, was automatisiert werden kann: von der Unterstützung einzelner Angriffsschritte hin zur autonomen Verknüpfung längerer Sequenzen. Für den Finanzsektor bedeutet dies, dass Zeit zu einer eigenständigen Risikodimension wird. Governance, Patch-Management, Überwachung und Recovery müssen nicht nur richtig konzipiert, sondern schnell genug ausgeführt werden.
Der regulatorische Kurs erscheint deshalb plausibel: keine vorschnelle Parallelregulierung, sondern konsequentere Anwendung bestehender Resilienzprinzipien, ergänzt um agentenspezifische Kontrollen, Drittanbieterperspektive und beschleunigte Informationsflüsse. In den kommenden Jahren dürfte sich die entscheidende Frage weniger darum drehen, ob Frontier-AI Cyberrisiken verändert, sondern wer die Geschwindigkeit der Technologie organisatorisch beherrscht. Institute mit sauberem Asset-Inventar, schneller Entscheidungsarchitektur, robusten Drittanbieterstrategien und realistisch getesteten Recovery-Fähigkeiten können die Technologie defensiv nutzen. Institute, die bereits heute bei Patch-Zyklen, Verantwortlichkeiten oder Abhängigkeitsmanagement Defizite haben, werden dagegen in einer maschinenschnellen Bedrohungsumgebung strukturell zurückfallen.
Die wichtigsten Ergebnissen kompakt zusammengefasst:
→ Frontier-AI ist ein qualitativer Sprung vor allem durch Geschwindigkeit, Skalierung und Autonomie – nicht durch völlig neue Angriffstechniken.
→ AI-gestützte Angriffe verkürzen das Zeitfenster zwischen Schwachstellenentdeckung und Exploitation drastisch; traditionelle Patch-Zyklen werden zu langsam.
→ GPT-5.5 und Claude Mythos Preview lösen bereits einen Großteil anspruchsvoller isolierter Cyberaufgaben und können in Testumgebungen längere Angriffsketten autonom ausführen.
→ Ungepatchte Software ist laut den in der Studie zitierten Daten inzwischen der wichtigste initiale Zugangsvektor bei Breaches.
→ Frontier-AI kann Verteidigung deutlich stärken, etwa bei Schwachstellensuche, Telemetrieanalyse, Threat Detection und Incident Response.
→ Finanzinstitute tragen zusätzliche Drittanbieter-, Konzentrations- und Sovereign-Access-Risiken durch gemeinsame Cloud-, Software- und AI-Anbieter.
→ Aufsichtsbehörden konvergieren auf einen pragmatischen Ansatz: bestehende Cyber- und Resilienzrahmen bleiben, müssen aber deutlich schneller und kontinuierlicher umgesetzt werden.
→ Governance wird zur operativen Sicherheitskontrolle: Board und Senior Management müssen Risiken verstehen, priorisieren und Entscheidungen unter stark verkürzten Fristen treffen können.
→ Information-Sharing und Public-Private Collaboration gewinnen systemische Bedeutung, weil Sicherheitswissen in einem maschinenschnellen Umfeld rasch veraltet.
Quelle:
- Crisanto, Juan Carlos; Currat, Adrien; Yong, Jeffery (2026): When machines attack: frontier AI cyber threats and policy responses in the financial sector. FSI Occasional Paper No 28, Financial Stability Institute, Bank for International Settlements, Basel, September 2026.