2.006 SIEM-Incidents, sieben Merkmale und eine Frage, die im Security Operations Center selten auf einem Dashboard steht: Welche Vorfälle ähneln sich – und welche passen plötzlich zu keinem bekannten Muster mehr? Clusteranalyse kann Cyber-Incidents in datengetriebene Gruppen strukturieren und Veränderungen dieser Gruppen sichtbar machen. Richtig eingesetzt entsteht daraus ein Frühwarnsystem für neue oder sich verschiebende Risikomuster.
Ein modernes SIEM sammelt Ereignisse aus Identitätsdiensten, Firewalls, Endpoints, Cloud-Plattformen, Anwendungen und Netzwerkkomponenten. Aus diesem Strom entstehen Regeln, Korrelationen und schließlich Incidents. Für das operative Security Monitoring ist das unverzichtbar. Trotzdem bleibt ein strukturelles Problem: Ein SIEM sieht häufig das, wonach es explizit sucht – oder bewertet einzelne Ereignisse mit einem Severity-Score. Was schwerer zu erkennen ist, sind Veränderungen in der Form des Geschehens: Eine neue Kombination aus wenigen fehlgeschlagenen Logins, ungewöhnlicher Privilegiennutzung, lateraler Bewegung und moderatem Datenabfluss kann für sich genommen unter mehreren Schwellenwerten bleiben und in der Gesamtheit dennoch ein neues Angriffsmuster bilden.
Hier setzt die Clusteranalyse an. Sie fragt nicht zuerst: "Ist dieser Incident bösartig?", sondern: "Welche Incidents sind sich über mehrere Merkmale hinweg ähnlich?" In der Statistik ist das explorative multivariate Analyse; im Machine Learning meist unüberwachtes Lernen. Log-Clustering wird in der Cybersecurity unter anderem für Überblick und Filterung, Signaturgewinnung, statische Ausreißererkennung sowie dynamische Anomalieerkennung eingesetzt [vgl. Romeike / Wieczorek 2026].
Der Charme liegt gerade darin, dass keine vollständig gelabelte Trainingshistorie benötigt wird. Das ist im Cyber-Risikomanagement relevant, weil unbekannte Angriffsmuster definitionsgemäß nicht sauber in alten Klassen vorliegen. Die Kehrseite ist ebenso wichtig: Ein ungewöhnlicher Cluster ist noch kein Angriff. Er kann genauso durch ein Software-Rollout, eine neue Cloud-Architektur, eine geänderte Logging-Konfiguration oder administrative Wartungsarbeiten entstehen. Cluster sind deshalb analytische Hypothesen – keine automatischen Beweise oder Schuldsprüche.
Clusteranalyse zwischen Diagnostic Analytics und Frühwarnung
Wir haben in unserem Buch "Data Analytics im Risikomanagement" die Clusteranalyse in den Kontext der Diagnostic Analytics einsortiert. Die Methode hilft, Strukturen und Risikotypen in vorhandenen Daten zu verstehen, ohne bereits eine zukünftige Zielgröße wie "Schaden ja/nein" zu prognostizieren [vgl. Romeike / Wieczorek 2026, S. 151-235]. Das entspricht auch der methodischen Logik: Clustering beschreibt zunächst Ähnlichkeit. Erst durch die zeitliche Beobachtung dieser Struktur kann daraus eine Frühwarnfunktion entstehen.
Für Cyberrisiken sind dabei drei Signale besonders interessant: Erstens kann ein Incident weit von allen bekannten Clustern entfernt liegen. Zweitens kann sich das Zentrum eines bestehenden Clusters verschieben – sogenannter Cluster Drift. Drittens kann eine Gruppe ungewöhnlicher Incidents über mehrere Zeitfenster wachsen und damit ein neues, stabiles Muster bilden. Genau dieser Übergang vom statischen Clustering zur Beobachtung der Clusterentwicklung ist in der Forschung zu dynamischer Log-Analyse explizit untersucht worden [vgl. Landauer et al. 2018].
Was wird eigentlich geclustert?
Für eine praxistaugliche Anwendung sollte nicht jede einzelne Logzeile als Beobachtung dienen. Sinnvoller ist häufig eine bereits korrelierte Incident-Einheit: Das SIEM fasst mehrere Events, Benutzer, Hosts und Zeitpunkte zu einem zusammenhängenden Fall zusammen. Aus jedem Incident wird anschließend ein Merkmalsvektor. Für das folgende Beispiel verwenden wir sieben Größen, die in realen Umgebungen aus SIEM-, EDR-, Identity- und Network-Telemetry abgeleitet werden könnten.
| Incident feature | Interpretation |
|---|---|
| Failed authentication attempts (60 min) | Anzahl fehlgeschlagener Authentifizierungen im relevanten Zeitfenster |
| Unique source IPs | Anzahl unterschiedlicher Quelladressen im Incident |
| Endpoints touched (6 h) | Anzahl betroffener bzw. kontaktierter Endpoints |
| Privileged actions (6 h) | Anzahl administrativer oder privilegierter Aktionen |
| Data egress (MB, 6 h) | Ausgehendes Datenvolumen; wegen Schiefe später logarithmiert |
| Off-hours share | Anteil der Aktivität außerhalb definierter Geschäftszeiten |
| ATT&CK tactics count | Anzahl unterschiedlicher zugeordneter MITRE-ATT&CK-Taktiken |
Tab. 01: Merkmale des fiktiven SIEM-Incident-Datensatzes [Quelle: Eigene Tabelle]
Die ATT&CK-Systematik ist dabei kein Risikoscore. MITRE beschreibt Taktiken als das taktische Ziel eines Angreifers – beispielsweise Credential Access, Privilege Escalation, Lateral Movement, Exfiltration oder Impact. Für die Clusteranalyse kann die Anzahl unterschiedlicher Taktiken jedoch als verdichtetes Merkmal dienen, das die Breite einer Angriffskette abbildet [vgl. MITRE ATT&CK 2026].
Praxisbeispiel: 2.006 Incidents aus einem fiktiven SIEM
Der im Beispiel verwendete Datensatz wurde vollständig synthetisch generiert. Er umfasst 2.006 korrelierte Incidents über 26 Wochen. Die ersten 18 Wochen mit 1.364 Incidents dienen als Baseline. Die Wochen 19 bis 26 enthalten 642 weitere Incidents und werden für das laufende Monitoring verwendet.
In der Baseline wurden vier unterschiedliche Verhaltensmuster simuliert, deren "wahre" Bezeichnungen dem Clusteralgorithmus nicht mitgegeben werden: Routine-Authentifizierungsrauschen, Credential-Attacken, laterale Bewegung mit Privilegienausweitung sowie Datenexfiltration bzw. Impact. Ab Woche 20 wird schrittweise ein fünftes Muster in die Daten eingeschleust: eine "Identity-to-Cloud"-Kette mit wenig sichtbarem Login-Rauschen, aber vielen berührten Systemen, intensiver Privilegiennutzung, Aktivitäten außerhalb der Geschäftszeiten und mehreren ATT&CK-Taktiken. Diese künstliche Ground Truth existiert nur, damit wir nachher prüfen können, ob das Frühwarnsignal tatsächlich auf die eingebaute Struktur reagiert.
Schritt 1: Daten transformieren und eine saubere Baseline bauen
Cyberdaten sind selten schön normalverteilt. Fehlgeschlagene Logins, Datenvolumen oder die Zahl berührter Systeme besitzen häufig lange rechte Verteilungsschwänze. Im Beispiel werden deshalb die positiven Zähl- und Volumenmerkmale mit ln(1+x) transformiert. Anschließend erfolgt die z-Standardisierung ausschließlich auf Basis der ersten 18 Wochen:
zᵢⱼ = (xᵢⱼ - x̄ⱼ,baseline) / sⱼ,baseline
Dieser scheinbar technische Punkt ist für ein Frühwarnsystem zentral. Würde man Mittelwerte und Standardabweichungen immer wieder aus allen neuen Daten berechnen, könnten sich neue Angriffsmuster schleichend selbst zur Normalität erklären. Die Baseline muss deshalb versioniert, ihre Gültigkeit überwacht und eine Rekalibrierung bewusst freigegeben werden. Dasselbe gilt für Feature-Definitionen: Eine geänderte SIEM-Regel oder ein neues EDR kann sonst einen künstlichen Cluster Drift erzeugen.
Schritt 2: Die Grundstruktur mit Clustering bestimmen
Für die Baseline werden mehrere Clusterzahlen getestet. K-Means eignet sich hier, weil die Merkmale nach Transformation und Standardisierung metrisch sind und sich neue Incidents später einfach über die Distanz zu den Clusterzentren zuordnen lassen. Zur explorativen Plausibilisierung kann zusätzlich eine hierarchische Analyse nach Ward verwendet werden. Entscheidend ist jedoch nicht der Name des Algorithmus, sondern ob die resultierenden Gruppen stabil, trennbar und fachlich interpretierbar sind.
Im synthetischen Baseline-Datensatz ergeben sich folgende mittlere Silhouettenwerte: k=2: 0,572; k=3: 0,653; k=4: 0,673; k=5: 0,494; k=6: 0,342. Die Vier-Cluster-Lösung ist damit in diesem Beispiel ein plausibler Ausgangspunkt. Der Silhouettenwert ist kein Wahrheitsbeweis, sondern ein Hinweis darauf, wie gut Beobachtungen zu ihrem eigenen Cluster passen und von anderen Clustern getrennt sind [vgl. Rousseeuw 1987].
Schritt 3: Aus mathematischen Gruppen Cyber-Risikomuster generieren
Erst nach dem Clustering beginnt die fachliche Interpretation. Die vier Baseline-Gruppen lassen sich anhand ihrer Merkmalsprofile ungefähr wie folgt lesen: Ein Cluster enthält überwiegend niedrigdimensionale Authentifizierungsereignisse mit wenig Folgeaktivität. Ein zweites Cluster zeigt massive Authentifizierungsversuche aus vielen Quelladressen - typisch für Credential Pressure. Ein drittes Cluster ist durch viele berührte Endpoints und privilegierte Aktionen geprägt. Das vierte Cluster weist dagegen wenig Login-Rauschen, aber sehr hohes ausgehendes Datenvolumen und eine größere Zahl unterschiedlicher ATT&CK-Taktiken auf.
Der Managementnutzen liegt nicht darin, Incidents nur schöner einzufärben. Die Gruppen erfordern unterschiedliche Reaktionen. Credential Pressure spricht für Identitätskontrollen, MFA, Rate Limiting und Source Intelligence. Laterale Bewegung lenkt den Blick auf Segmentierung, privilegierte Konten und EDR-Telemetrie. Exfiltrationsnahe Muster verlangen andere Fragen: Welche Datenklassen waren betroffen? Welche Cloud- oder Netzwerkpfade wurden genutzt? Welche DLP- und Egress-Kontrollen haben versagt?
Schritt 4: Aus Clustern ein Frühwarnsignal ableiten
Bis hierhin ist die Analyse diagnostisch. Für die Frühwarnung wird nun jeder neue Incident mit der Baseline verglichen. Eine einfache Kennzahl ist die Distanz zum nächstgelegenen bekannten Clusterzentrum. Für einen standardisierten Incident-Vektor zᵢ und die Baseline-Zentren μc gilt:
dᵢ = min_c || zᵢ - μc ||₂
Kleine Werte bedeuten: Der Incident ähnelt einem bekannten Muster. Große Werte bedeuten: Die Kombination der Merkmale ist für die Baseline ungewöhnlich. Im Beispiel wird als erste technische Schwelle das 95-%-Quantil der Baseline-Distanzen verwendet. Es liegt bei 1,25 im standardisierten Merkmalsraum. Per Definition lagen in der Baseline ungefähr fünf Prozent der Incidents oberhalb dieser Schwelle.
Für die operative Frühwarnung ist ein einzelner Ausreißer jedoch zu wenig. Interessanter ist der Anteil ungewöhnlicher Incidents pro Zeitfenster. Ein möglicher Key Risk Indicator lautet deshalb:
Wₜ = Anzahl{dᵢ > q₀.₉₅} / Anzahl aller Incidents im Zeitfenster t
Im Beispiel bleibt Wt zunächst in der Größenordnung von wenigen Prozent. Ab Woche 22 steigt der Anteil jedoch auf 12,2 Prozent, in Woche 23 auf 18,4 Prozent, in Woche 25 auf 24,1 Prozent und in Woche 26 auf 32,2 Prozent. Eine illustrative Warnschwelle von zehn Prozent würde damit in Woche 22 ausgelöst. Diese zehn Prozent sind keine universelle Empfehlung; in einer realen Umgebung müssten Schwellen aus Fehlalarmkosten, Incident-Volumen, Kritikalität und historischer Stabilität kalibriert werden.
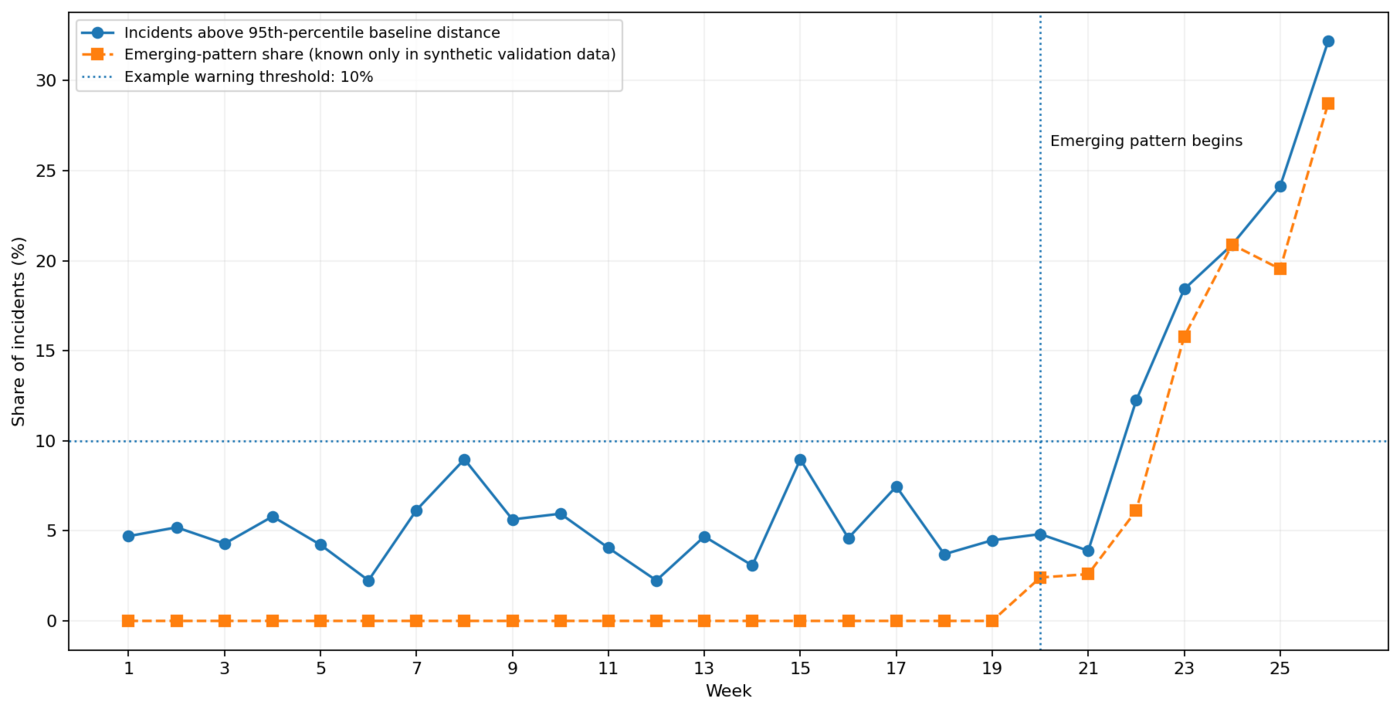 Abb. 01: Wöchentliches Frühwarnsignal, basierend auf dem Anteil der Vorfälle, deren Abstand zu allen Referenzclustern das 95. Perzentil überschreitet. Die gestrichelte Validierungsreihe ist nur verfügbar, da das Beispiel synthetische Ground-Truth-Daten verwendet [Quelle: Eigene Abbildung]
Schritt 5: Wenn aus Ausreißern ein neues Cluster wird
Der Anstieg des Frühwarnindikators beantwortet noch nicht, was passiert. Er sagt lediglich: Die neue Incident-Landschaft passt schlechter zur Baseline. Deshalb wird das jüngste Datenfenster – Wochen 19 bis 26 – erneut explorativ geclustert. Bei k=4 beträgt der Silhouettenwert 0,614; mit k=5 steigt er auf 0,684. In dem künstlichen Datensatz bildet sich tatsächlich ein fünftes, stabil erkennbares Muster mit 79 Incidents.
Das Profil ist bemerkenswert: Im Mittel nur rund sechs fehlgeschlagene Authentifizierungen pro Stunde und etwa 1,2 Quell-IP-Adressen – also gerade kein lautes Password Spraying. Gleichzeitig werden etwa 24 Endpoints in sechs Stunden berührt, rund 14 privilegierte Aktionen ausgeführt, etwa 1.100 MB Daten übertragen, 93 Prozent der Aktivität liegt außerhalb der Geschäftszeiten und im Durchschnitt werden rund 7,5 unterschiedliche ATT&CK-Taktiken berührt. Fachlich wäre das ein Muster, das eine SOC-Analyse sofort verdienen würde: wenig Lärm am Perimeter, aber eine breite und tiefe Bewegung innerhalb der Umgebung.
| Cluster | Auth failures | Source IPs | Endpoints | Priv. actions | Egress MB | Off-hours | ATT&CK tactics |
|---|---|---|---|---|---|---|---|
| A Routine authentication noise | 24.7 | 1.5 | 1.0 | 0.1 | 20 | 0.15 | 0.7 |
| B Credential attack | 179.1 | 28.0 | 1.8 | 0.4 | 35 | 0.35 | 1.8 |
| C Lateral movement / privilege escalation | 18.5 | 2.5 | 15.0 | 9.0 | 120 | 0.60 | 4.8 |
| D Data exfiltration / impact | 10.2 | 1.5 | 3.5 | 2.8 | 3,000 | 0.75 | 5.4 |
| E Emerging identity-to-cloud pattern | 6.1 | 1.2 | 24.0 | 14.0 | 1,100 | 0.93 | 7.5 |
Tab. 02: Gerundete Mittelwerte der im jüngsten Datenfenster identifizierten Incident-Cluster auf der ursprünglichen Skala [Quelle: Eigene Tabelle]7
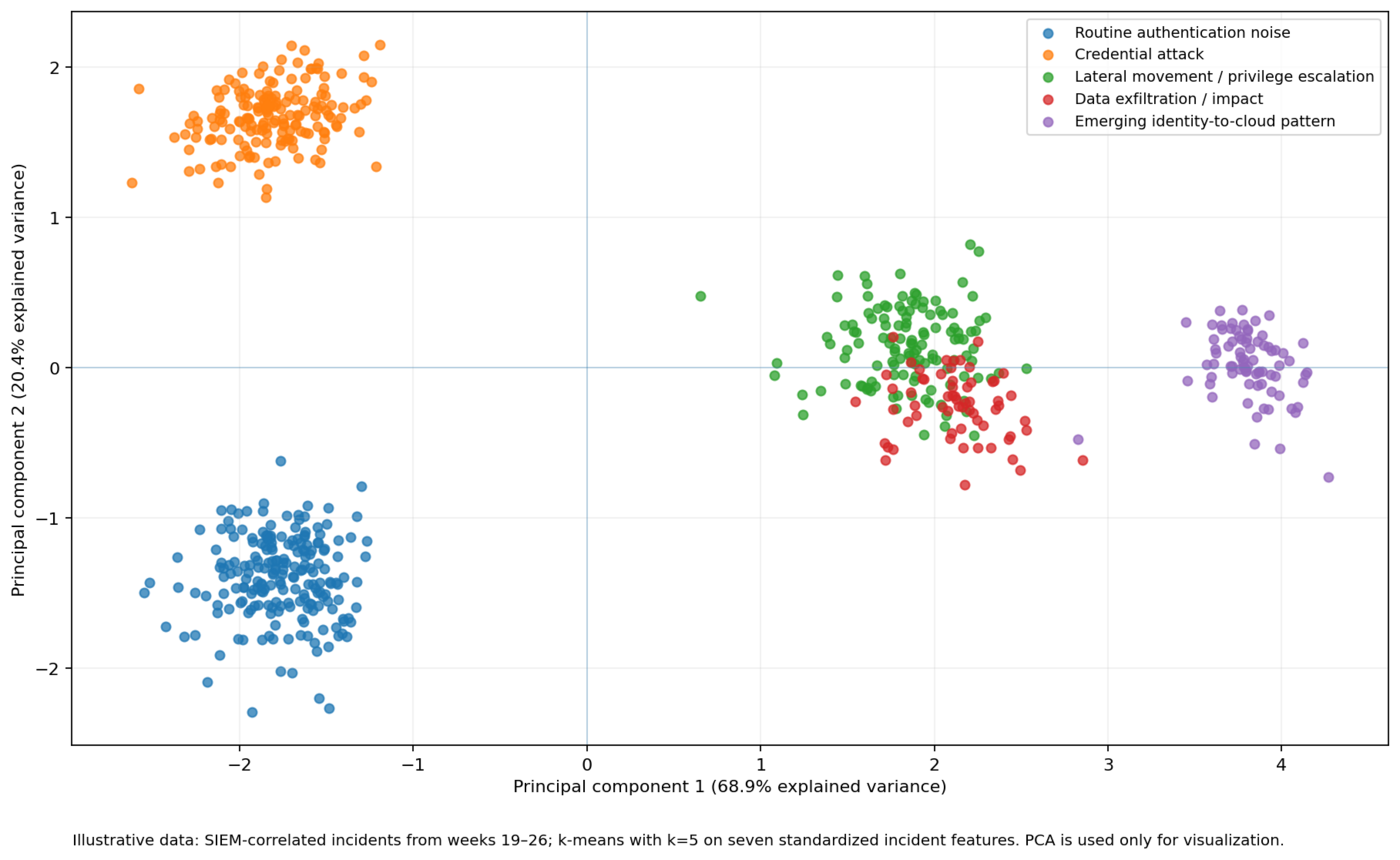 Abb. 02: PCA-Projektion der fünf aufgetretenen Cluster im letzten Überwachungszeitraum. Die Clusterbildung selbst erfolgt im sieben-dimensionalen standardisierten Merkmalsraum; die PCA dient lediglich der Visualisierung [Quelle: Eigene Abbildung].
 Abb. 03: Standardisierte Merkmalsprofile der fünf Vorfallcluster. Das sich abzeichnende "Identity-to-Cloud"-Muster zeichnet sich durch eine ungewöhnliche Kombination aus Endpunktverteilung, privilegierten Aktionen, Datenausgang, Aktivitäten außerhalb der Geschäftszeiten und der Breite des ATT&CK-Spektrums aus [Quelle: Eigene Abbildung]
Was das Risikomanagement aus dem neuen Muster lernen kann
Für das SOC lautet die erste Frage: Sind die 79 Incidents tatsächlich technisch zusammenhängend? Für das Risikomanagement beginnt danach die zweite Ebene: Welche Veränderung des Risikoprofils steckt dahinter? Wenn sich beispielsweise herausstellt, dass mehrere Fälle mit kompromittierten Cloud-Identitäten, privilegierten Rollen und lateraler Bewegung über SaaS- oder Identity-Plattformen verbunden sind, ist das nicht nur ein Detection-Thema. Es kann auf eine veränderte Angriffskette und auf eine Lücke in den bestehenden Kontrollen hinweisen.
Aus dem Cluster lassen sich dann konkrete Hypothesen und Maßnahmen ableiten: Sind phishing-resistente MFA und Conditional Access für privilegierte Identitäten ausreichend ausgerollt? Werden ungewöhnliche Role Assignments und Service-Principal-Aktivitäten erfasst? Sind Netzwerk- und Cloud-Signale im SIEM tatsächlich korreliert? Welche kritischen Assets tauchen überproportional im neuen Muster auf? Müssen Cyber-Szenarien, Stressannahmen oder die Bewertung im Risikoregister aktualisiert werden?
Damit wird aus einer technischen Anomalie ein Risiko-Frühwarnsignal. Nicht weil der Algorithmus den nächsten Schaden vorhersagt, sondern weil er eine Strukturveränderung sichtbar macht, bevor sie möglicherweise in den klassischen Schadenstatistiken erscheint. Das ist ein wichtiger Unterschied: Frühwarnung ist nicht dasselbe wie Prognose.
Ein Frühwarnsystem braucht mehr als einen Distanzwert
In einer produktiven Umsetzung sollte die Distanz zum Clusterzentrum nie die einzige Kennzahl sein. Robuster wird das System, wenn mehrere Perspektiven kombiniert werden. Denkbar sind insbesondere vier Kategorien von Frühwarnindikatoren:
- Novelty: Anteil der Incidents oberhalb eines definierten Distanz- oder Dichte-Schwellenwerts.
- Persistence: Dauer und Größe neu entstehender Cluster über mehrere Zeitfenster.
- Drift: Verschiebung bestehender Clusterzentren und ihrer Merkmalsprofile.
- Criticality: Konzentration ungewöhnlicher Incidents auf kritische Assets, privilegierte Identitäten oder besonders schützenswerte Daten.
Erst die Verbindung dieser technischen Indikatoren mit Asset-Kritikalität, Kontrollinformationen und potenziellen Schadensszenarien macht die Analyse für das Enterprise Risk Management wertvoll. Ein neues Cluster auf Testsystemen ist etwas anderes als dasselbe Muster auf Domain Controllern, produktiven Cloud-Tenants oder Systemen mit personenbezogenen bzw. geschäftskritischen Daten.
Die größten Fallstricke liegen außerhalb des Algorithmus
Wie im klassischen Clustering gilt auch hier: Das Ergebnis hängt von der Modellierung ab. Wenn zehn Netzwerkmerkmale, aber nur ein Identitätsmerkmal eingehen, ist "Ähnlichkeit" bereits ungleich gewichtet. Wenn ein großer Datenabfluss nicht logarithmiert oder robust behandelt wird, kann er alle anderen Dimensionen dominieren. Wenn SIEM-Korrelationen geändert werden, verändert sich möglicherweise die Beobachtungseinheit selbst.
Hinzu kommt das Problem des Concept Drift. IT-Landschaften ändern sich ständig. Cloud-Migrationen, neue Endpoints, Schichtmodelle, M&A-Integrationen oder Security-Tool-Rollouts können legitime neue Cluster erzeugen. Das Frühwarnsystem muss daher zwischen "neuer Angriff" und "neuer Normalität" unterscheiden lernen – und braucht dafür Analystenfeedback, Change-Daten und eine dokumentierte Rekalibrierung.
Besonders heikel ist automatisches Nachlernen. Ein Modell, das jede neue Beobachtung sofort in seine Normalität aufnimmt, kann einen langsam wachsenden Angriff schrittweise absorbieren. Für Governance und Nachvollziehbarkeit ist deshalb eine Trennung sinnvoll: eine eingefrorene Referenz-Baseline für die Detektion, ein separates Beobachtungsfenster für mögliche neue Strukturen und eine kontrollierte Freigabe, bevor Zentren oder Schwellen aktualisiert werden.
Sommer und Paxson haben bereits im Jahr 2010 darauf hingewiesen, dass Machine-Learning-Ansätze für Intrusion Detection im realen Betrieb mit anderen Randbedingungen kämpfen als in geschlossenen Forschungsdatensätzen. Netzwerke verändern sich, Ground Truth ist knapp und Fehlalarme sind operativ teuer [vgl. Sommer / Paxson 2010]. Genau deshalb sollte Clusteranalyse im Cyber-Risikomanagement nicht als magische KI-Schicht verstanden werden, sondern als zusätzliches diagnostisches Instrument mit klaren Kontrollen und menschlicher Validierung.
Von Diagnostic zu Predictive Analytics
Die Clusteranalyse selbst bleibt im Kern diagnostisch: Sie beantwortet die Frage, welche Strukturen in den vorhandenen Incident-Daten liegen und wie sich diese Strukturen verändern. Der Schritt zu Predictive Analytics beginnt erst, wenn eine zukünftige Zielgröße modelliert wird – etwa "Incident eskaliert zu bestätigtem Breach", "Produktionsunterbrechung > 24 Stunden" oder "Datenverlust > 1 Mio. Euro".
Cluster können für diesen nächsten Schritt dennoch wertvoll sein. Die Clusterzugehörigkeit, die Distanz zum Zentrum oder ein Drift-Indikator können als zusätzliche Variablen in ein Prognosemodell eingehen. Ebenso lässt sich prüfen, ob bestimmte Cluster in der Zukunft häufiger zu schweren Incidents führen. Methodisch muss dann aber strikt zwischen Training, Validierung und Test getrennt werden. Skalierung, Clusterzentren und Schwellen dürfen nicht mit Informationen aus der Zukunft kalibriert werden.
Sonst entsteht Datenleckage – und das vermeintlich brillante Frühwarnsystem kennt die Antwort schon aus dem Prüfungsbogen.
Damit schließt sich der Bogen zur Logik von Data Analytics im Risikomanagement: Descriptive Analytics beschreibt die Ereignisse, Diagnostic Analytics strukturiert Muster und Auffälligkeiten, Predictive Analytics untersucht zukünftige Entwicklungen. Gerade im Cyber-Risikomanagement entsteht der größte Nutzen oft nicht aus einer einzelnen Methode, sondern aus dieser analytischen Kette [vgl. Romeike / Wieczorek 2026].
Fazit: Jedes neue Cluster verdient eine Frage
Clusteranalyse kann aus tausenden SIEM-Incidents eine wesentlich verständlichere Risikolandschaft machen. Ihr größter Mehrwert liegt nicht in der nachträglichen Sortierung bekannter Fälle, sondern in der Fähigkeit, Veränderungen sichtbar zu machen: Incidents, die zu keinem bekannten Muster passen, Cluster, die sich verschieben, und neue Gruppen, die über mehrere Wochen wachsen.
Im fiktiven Beispiel entsteht die Warnung nicht durch einen einzelnen roten Alarm. Sie entsteht, weil der Anteil der Incidents außerhalb der bekannten Baseline von ungefähr fünf Prozent auf mehr als 30 Prozent steigt und sich anschließend ein fünftes, fachlich plausibles Muster herausbildet. Genau darin liegt die Idee eines datengetriebenen Frühwarnsystems: Nicht nur fragen, ob ein Incident einen Grenzwert überschreitet, sondern ob sich die Struktur der Cyberrisiken gerade verändert.
Vielleicht ist das die wichtigste Managementfrage: Nicht "Wie viele Alerts hatten wir diesen Monat?", sondern "Sehen unsere Incidents noch so aus wie gestern?" Wenn die Antwort Nein lautet, sollte das Risikomanagement genauer hinsehen.
Quellenverzeichnis und weiterführende Literaturhinweise
- Landauer, Max / Skopik, Florian / Wurzenberger, Markus / Rauber, Andreas (2020): System Log Clustering Approaches for Cyber Security Applications: A Survey. Computers & Security, 92, 101739. DOI: 10.1016/j.cose.2020.101739.
- Landauer, Max / Wurzenberger, Markus / Skopik, Florian / Settanni, Giuseppe / Filzmoser, Peter (2018): Dynamic Log File Analysis: An Unsupervised Cluster Evolution Approach for Anomaly Detection. Computers & Security, 79, S. 94-116. DOI: 10.1016/j.cose.2018.08.009.
- Romeike, Frank / Wieczorek, Gabriele (2026): Data Analytics im Risikomanagement - Descriptive Analytics - Diagnostic Analytics - Predictive Analytics. Springer Gabler, Wiesbaden. Clusteranalyse: S. 151-235. DOI: 10.1007/978-3-658-48843-7.
- Rousseeuw, Peter J. (1987): Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, S. 53-65. DOI: 10.1016/0377-0427(87)90125-7.
- Sommer, Robin / Paxson, Vern (2010): Outside the Closed World: On Using Machine Learning for Network Intrusion Detection. 2010 IEEE Symposium on Security and Privacy. DOI: 10.1109/SP.2010.25.
- García-Teodoro, Pedro / Díaz-Verdejo, Jesús / Maciá-Fernández, Gabriel / Vázquez, Enrique (2009): Anomaly-based network intrusion detection: Techniques, systems and challenges. Computers & Security, 28(1-2), S. 18-28. DOI: 10.1016/j.cose.2008.08.003.
- MITRE (2026): MITRE ATT&CK - Enterprise Tactics. https://attack.mitre.org/tactics/ (abgerufen am 23.10.2026).