300 Lieferanten, sechs Risikomerkmale und eine einzige Frage: Welche Lieferanten sind sich wirklich ähnlich? Die Clusteranalyse versucht, verborgene Strukturen in mehrdimensionalen Daten sichtbar zu machen – ohne vorher festzulegen, welche Gruppen existieren sollen. Gerade im Risikomanagement ist das attraktiv: Statt jede Kennzahl isoliert mit einer Ampel zu versehen, lassen sich ganze Risikoprofile erkennen. Doch damit aus mathematischer Nähe eine belastbare Managementaussage wird, müssen Distanzmaß, Skalierung, Clusterzahl und Validierung methodisch sauber gewählt werden.
Warum eine Ampel oft zu wenig ist
Risikoberichte sind häufig eindimensional aufgebaut: Bonität schlecht – rot. Liefertermintreue schwach – rot. Hohe Single-Source-Abhängigkeit – ebenfalls rot. Diese Logik ist einfach, aber sie zerlegt ein mehrdimensionales Risikoprofil in einzelne Warnlampen. Zwei Lieferanten können dieselbe Bonität besitzen und dennoch völlig unterschiedlich kritisch sein: Der eine liefert ein problemlos ersetzbares Standardteil aus dem Inland, der andere ein kundenspezifisches Bauteil mit neun Monaten Wiederbeschaffungszeit aus einer geopolitisch exponierten Region.
Clusteranalyse setzt an einer anderen Stelle an. Sie fragt nicht zuerst, ob ein einzelner Messwert einen Grenzwert überschreitet, sondern welche Beobachtungen sich über mehrere Merkmale hinweg ähneln. In der Statistik gehört sie zu den Verfahren der explorativen multivariaten Analyse; im Machine Learning wird sie meist dem unüberwachten Lernen zugerechnet. Es gibt also keine vorab bekannte Zielvariable wie "Ausfall ja/nein", die das Modell lernen soll. Die Gruppen entstehen aus der Struktur der Daten selbst.
Damit passt die Methode gut zur Diagnostic Analytics: Sie hilft, Muster und Struktur in komplexen Daten zu verstehen. Sie liefert allerdings noch keine Kausaldiagnose. Ein Cluster sagt zunächst: "Diese Objekte ähneln sich nach der gewählten mathematischen Definition." Warum sie sich ähneln und welche Maßnahmen daraus folgen, bleibt eine fachliche Interpretationsaufgabe. [vgl. Romeike / Wieczorek 2026]
Was ist mathematisch ein Cluster?
Stellen wir jeden Lieferanten als Punkt in einem mehrdimensionalen Merkmalsraum dar. Bei sechs Risikomerkmalen besitzt jeder Lieferant sechs Koordinaten. Ein Clusterverfahren sucht dann Gruppen, in denen die Abstände zwischen den Punkten klein und die Abstände zu anderen Gruppen möglichst groß sind. Was "klein" bedeutet, hängt vom Distanzmaß ab.
Für metrische Daten wird häufig die euklidische Distanz verwendet. Nach Standardisierung der Merkmale lautet sie für zwei Lieferanten i und l:
d(i,l) = √ [ Σⱼ (zᵢⱼ - zₗⱼ)² ]
Die Formel enthält eine zentrale Modellentscheidung: Sie setzt voraus, dass Unterschiede auf allen berücksichtigten Variablen sinnvoll miteinander verrechnet werden können. Genau deshalb ist die Datenvorbereitung kein Nebenschritt, sondern Teil der Methode.
Schritt 1: Erst die Skalen vergleichbar machen
Eine Ausfallwahrscheinlichkeit von 0 bis 10 Prozent, eine Lieferzeitstreuung von 0 bis 30 Tagen und ein Cyber-Exposure-Score von 0 bis 100 leben auf völlig unterschiedlichen Skalen. Würde man Rohwerte direkt in eine euklidische Distanz einsetzen, könnten Variablen mit großen Zahlenbereichen die Gruppierung dominieren - unabhängig von ihrer fachlichen Bedeutung.
Eine Standardlösung ist die z-Standardisierung. Von jedem Wert wird der Mittelwert der Variable abgezogen und anschließend durch ihre Standardabweichung geteilt:
zᵢⱼ = (xᵢⱼ - x̄ⱼ) / sⱼ
Danach bedeutet ein z-Wert von +1 ungefähr: eine Standardabweichung über dem Mittelwert. Dadurch werden die Variablen rechnerisch vergleichbarer. Gleichzeitig entsteht eine wichtige Governance-Frage: Wenn drei fast identische Finanzkennzahlen, aber nur eine Cyberkennzahl in die Analyse eingehen, erhält das Thema "Finanzen" faktisch ein höheres Gewicht. Feature-Auswahl ist daher immer auch Risikomodellierung.
Schritt 2: Ein Verfahren wählen, das zur Datenstruktur passt
K-Means ist eines der bekanntesten Clusterverfahren. MacQueen beschrieb den Ansatz 1967 als effiziente Methode, Beobachtungen in k Gruppen einzuteilen [vgl. Romeike / Wieczorek 2026, S. 151]. Vereinfacht sucht der Algorithmus k Zentren und ordnet jeden Punkt dem nächstgelegenen Zentrum zu. Anschließend werden die Zentren neu berechnet. Das wird wiederholt, bis sich die Lösung kaum noch verändert. Optimiert wird die Summe der quadrierten Abstände innerhalb der Cluster:
min Σc Σᵢ ∈ C_c || zᵢ - μ_c ||²
Das macht K-Means schnell und gut interpretierbar, aber nicht universell. Das Verfahren bevorzugt eher kompakte, ungefähr kugelförmige Cluster und reagiert auf Ausreißer. Außerdem muss k vorher festgelegt werden. Bei stark ungleich großen oder nicht-konvexen Gruppen können andere Verfahren geeigneter sein.
Eine klassische Alternative ist die hierarchische Clusteranalyse. Beim agglomerativen Vorgehen startet jede Beobachtung als eigenes Cluster; anschließend werden schrittweise diejenigen Gruppen zusammengeführt, die nach einem gewählten Kriterium am besten zusammenpassen. Das Ward-Verfahren minimiert bei jedem Zusammenschluss den zusätzlichen Verlust an Homogenität innerhalb der Gruppen [vgl. Ward 1963]. Das Ergebnis lässt sich als Dendrogramm darstellen – ein Stammbaum der Ähnlichkeiten (vgl. Abb. 01).
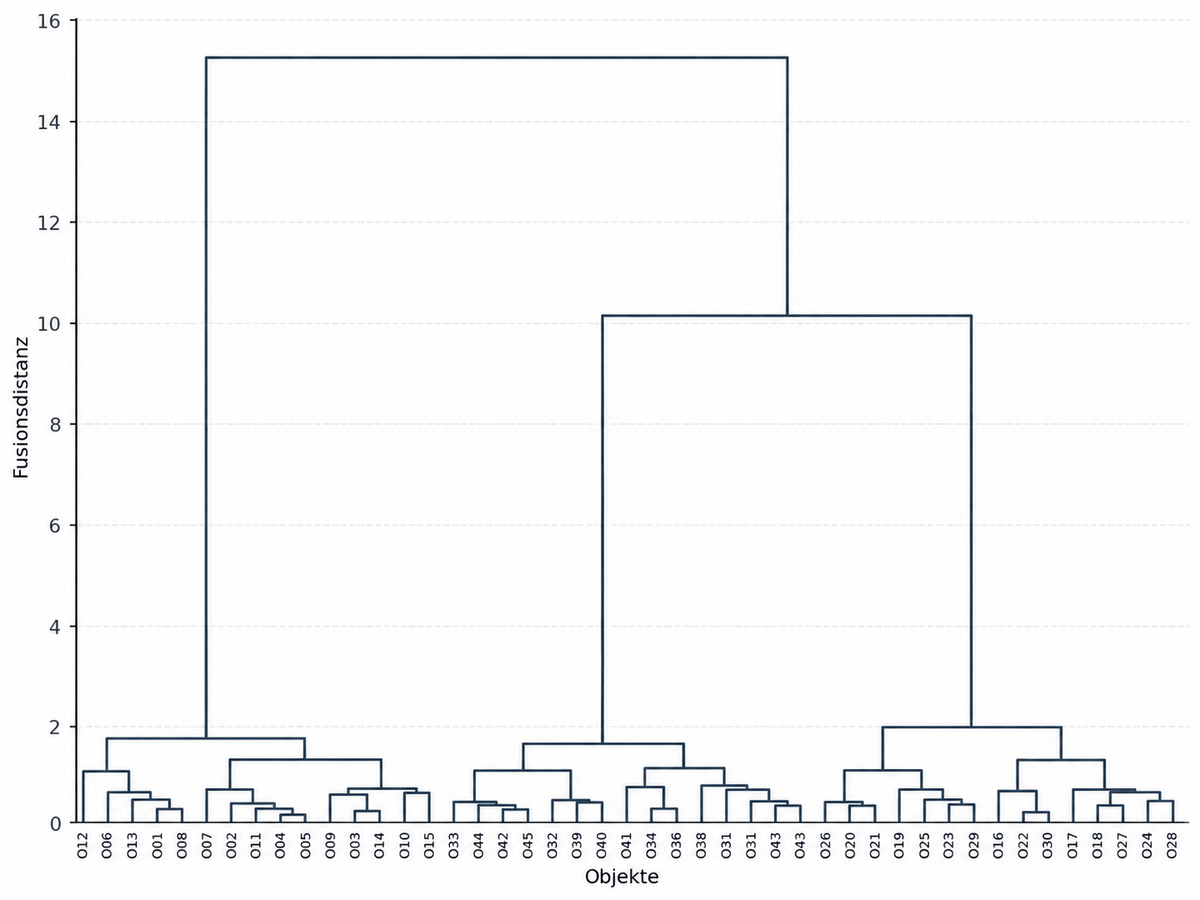 Abb. 01: Dendrogramm der hierarchischen Clusteranalyse – schrittweise Zusammenführung ähnlicher Objekte nach dem Ward-Verfahren [Quelle: Eigene Abbildung basierend auf illustrativen Daten]
Sind neben metrischen Größen auch Kategorien enthalten – etwa Region, Zertifizierungsstatus oder Beschaffungsart –, ist eine einfache euklidische Distanz oft nicht mehr sinnvoll. Dann kommen beispielsweise Gower-Distanzen in Kombination mit hierarchischen Verfahren oder Partitioning Around Medoids in Betracht [vgl. Romeike / Wieczorek, S. 169]. Die methodische Faustregel lautet: Nicht den Algorithmus an die Daten zwingen, sondern die Datenart zum Algorithmus passen lassen.
Schritt 3: Wie viele Cluster sind "richtig"?
Die unangenehme Antwort lautet: Meist gibt es nicht die eine objektiv richtige Zahl. Eine Clusterlösung ist ein Modell der Datenstruktur. Verschiedene Auflösungen können gleichzeitig sinnvoll sein – ähnlich wie eine Landkarte je nach Maßstab andere Details zeigt.
Trotzdem gibt es quantitative Hilfen. Die Elbow-Methode betrachtet, wie stark die Streuung innerhalb der Cluster sinkt, wenn k erhöht wird. Die Silhouettenmethode von Rousseeuw vergleicht für jede Beobachtung die Nähe zum eigenen Cluster mit der Nähe zum nächstgelegenen fremden Cluster. Der Silhouettenwert liegt zwischen -1 und +1; hohe positive Werte sprechen für eine gut getrennte Zuordnung. Die Gap-Statistik von Tibshirani, Walther und Hastie vergleicht die beobachtete Clusterstruktur mit einer geeigneten Referenzverteilung ohne ausgeprägte Cluster [vgl. Tibshirani / Walther / Hastie 2001].
Entscheidend ist: Kein Kennwert sollte allein entscheiden. Eine gute Clusterlösung sollte statistisch plausibel, stabil gegenüber kleinen Datenänderungen, fachlich interpretierbar und für Entscheidungen nutzbar sein. Vier mathematisch saubere Cluster, die niemand im Unternehmen erklären oder unterschiedlich behandeln kann, sind analytisch interessant – aber operativ wertlos.
Methodenkompass für die Praxis
1. Fragestellung und Beobachtungseinheit definieren.
2. Variablen fachlich auswählen und Datenqualität prüfen.
3. Skalieren/transformieren und geeignetes Distanzmaß festlegen.
4. Mehrere Clusterverfahren und mehrere k-Werte testen.
5. Interne Gütemaße, Stabilität und fachliche Plausibilität vergleichen.
6. Cluster erst danach benennen und Maßnahmen ableiten.
Praxisbeispiel: 300 Lieferanten, sechs Risikodimensionen
Nehmen wir ein Industrieunternehmen mit 300 aktiven Lieferanten. Für jeden Lieferanten werden sechs Risikodimensionen beobachtet: geschätzte Ausfallwahrscheinlichkeit, Volatilität der Lieferzeit, Single-Source-Abhängigkeit, geopolitisches Exposure, Qualitätsabweichungsquote und Cyber-Exposure. Alle Variablen werden so kodiert, dass höhere Werte ein höheres Risiko oder Exposure bedeuten. Die folgenden Zahlen sind bewusst synthetisch und dienen ausschließlich der Illustration; sie sind weder empirische Benchmarks noch Daten aus dem Buch von Romeike und Wieczorek.
Nach Datenbereinigung werden die sechs Merkmale z-standardisiert. Anschließend wird K-Means für mehrere Werte von k gerechnet. In der künstlich erzeugten Stichprobe ergibt k = 4 einen mittleren Silhouettenwert von 0,62. Zum Vergleich: k = 3 erreicht 0,53 und k = 5 rund 0,54. Das ist kein Beweis dafür, dass vier Cluster "wahr" sind, aber ein quantitatives Argument dafür, diese Lösung genauer zu prüfen.
Für die Visualisierung werden die sechs standardisierten Dimensionen mit einer Hauptkomponentenanalyse (PCA) auf zwei Achsen projiziert. Die ersten beiden Komponenten erklären in diesem Beispiel rund 76 Prozent der Varianz. Wichtig: Die PCA erzeugt hier nicht die Cluster. Sie dient nur dazu, den sechs-dimensionalen Raum in einer zweidimensionalen Abbildung sichtbar zu machen.
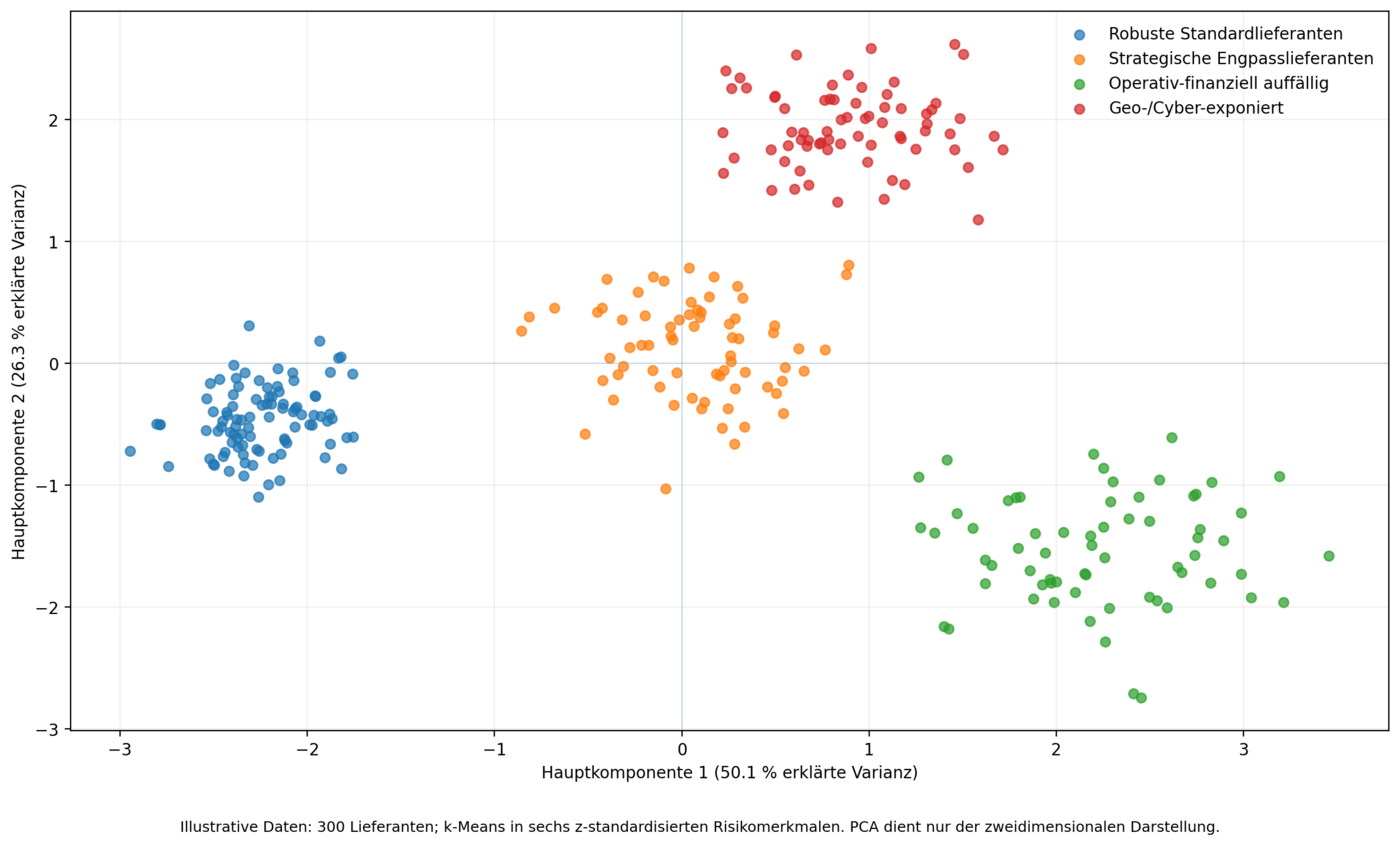 Abb. 02: Zweidimensionale PCA-Projektion der vier K-Means-Cluster. Die Clusterbildung selbst erfolgte im sechs-dimensionalen standardisierten Merkmalsraum [Quelle: Eigene Abbildung basierend auf illustrativen Daten]
Aus Punkten werden Risikotypen
Die vier Gruppen sind zunächst nur mit den neutralen Nummern 1 bis 4 versehen. Erst die Analyse der Clusterzentren erlaubt eine fachliche Interpretation. Genau dieser Schritt ist für den Einsatz im Risikomanagement entscheidend: Der Algorithmus kennt weder "strategisch" noch "kritisch". Diese Begriffe entstehen erst durch den Vergleich der Merkmalsprofile.
| Cluster | Ausfall-% | Lieferzeitvol. (Tage) | Single-Source % | Geo-Exposure | Qualitätsabweichung % | Cyber-Exposure |
|---|---|---|---|---|---|---|
| A Robuste Standardlieferanten | 1,2 | 3,0 | 18 | 19 | 0,7 | 21 |
| B Strategische Engpasslieferanten | 1,9 | 9,4 | 82 | 43 | 1,2 | 34 |
| C Operativ-finanziell auffällig | 6,5 | 13,2 | 49 | 38 | 4,3 | 44 |
| D Geo-/Cyber-exponiert | 2,4 | 8,4 | 41 | 83 | 1,6 | 78 |
Tab. 01: Gerundete Clusterzentren auf der ursprünglichen Skala [Quelle: Eigene Tabelle basierend auf illustrativen Daten]
Cluster A ist in nahezu allen Dimensionen unterdurchschnittlich exponiert. Diese Lieferanten wären Kandidaten für einen schlanken Standardprozess. Cluster B fällt dagegen nicht durch schlechte Bonität oder Qualitätsprobleme auf, sondern durch sehr hohe Single-Source-Abhängigkeit und erhöhte Lieferzeitvolatilität. Genau hier zeigt sich der Mehrwert gegenüber einer einfachen Risikosumme: Ein ökonomisch gesunder Lieferant kann trotzdem ein strategischer Engpass sein.
Cluster C kombiniert eine erhöhte Ausfallwahrscheinlichkeit mit hoher Lieferzeitvolatilität und Qualitätsabweichungen. Ein einheitliches Maßnahmenpaket könnte hier engere Bonitätsbeobachtung, Qualitätsreviews und alternative Beschaffungsoptionen verbinden. Cluster D ist finanziell vergleichsweise unauffällig, weist jedoch sehr hohe geopolitische und Cyber-Exposures auf. Dafür wären andere Instrumente sinnvoll: Standort- und Sanktionsmonitoring, Cyber-Assessments, alternative Logistikrouten und Business-Continuity-Szenarien.
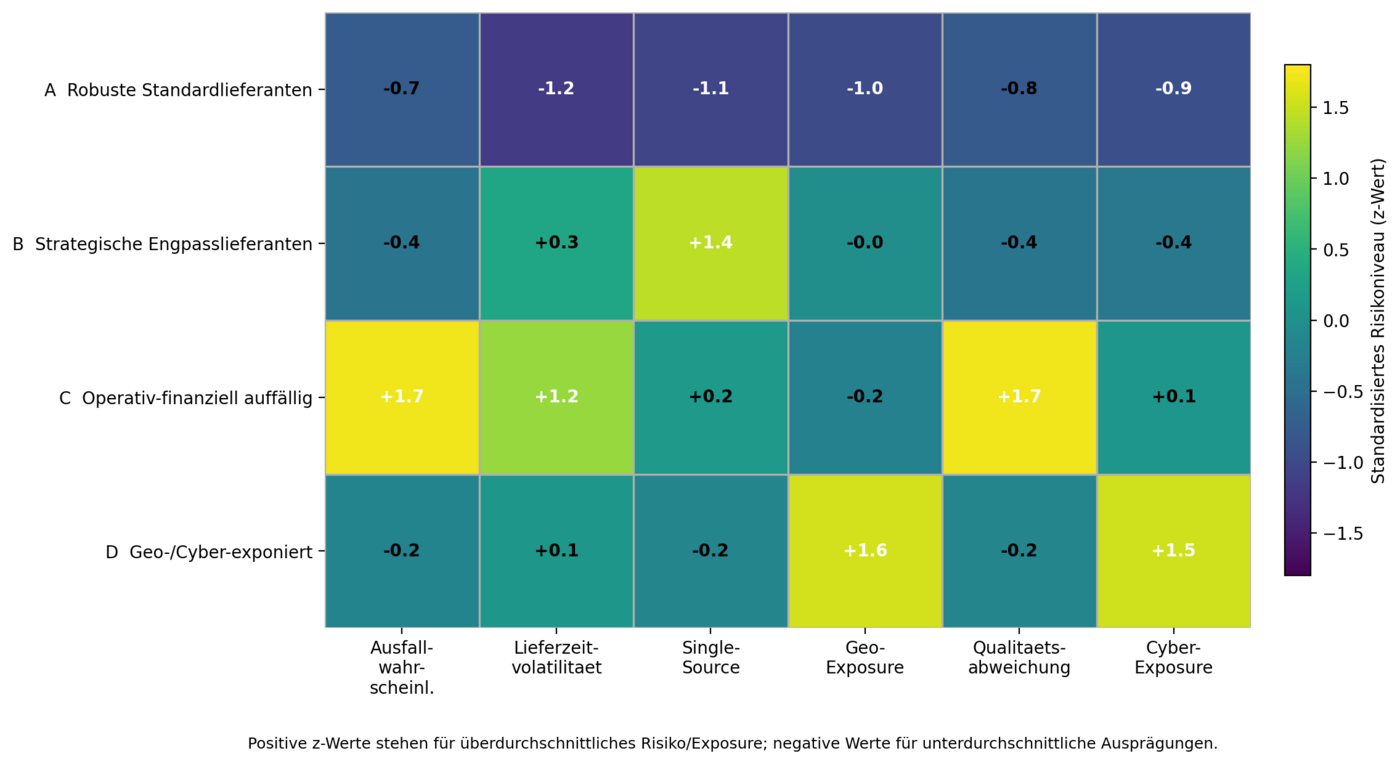 Abb. 03: Standardisierte Risikoprofile der vier Cluster. Positive z-Werte zeigen überdurchschnittliche, negative z-Werte unterdurchschnittliche Ausprägungen [Quelle: Eigene Abbildung basierend auf illustrativen Daten]
Ein einzelner Lieferant im Modell
Wie würde eine konkrete Beobachtung aussehen? Nehmen wir Lieferant L-184 mit 6,8 Prozent geschätzter Ausfallwahrscheinlichkeit, 14 Tagen Lieferzeitvolatilität, 52 Prozent Single-Source-Abhängigkeit, einem geopolitischen Exposure von 36/100, 4,5 Prozent Qualitätsabweichungen und einem Cyber-Exposure von 47/100. Nach Standardisierung liegt dieses Profil nahe am Zentrum von Cluster C. Das Modell würde den Lieferanten also nicht einfach als "rot" bezeichnen, sondern einem spezifischen Muster zuordnen: operativ-finanziell auffällig. Daraus lässt sich ein gezielteres Maßnahmenpaket ableiten als aus sechs isolierten Ampeln.
Wichtig bleibt jedoch die Reihenfolge: Erst mathematisch clustern, dann fachlich benennen. Wer die gewünschte Typologie schon vorab im Kopf hat und anschließend Variablen, Skalierung oder k so lange verändert, bis die erwarteten Gruppen erscheinen, betreibt keine explorative Analyse mehr, sondern bestätigt seine Vorannahmen.
Cluster sind Hypothesen, keine Naturgesetze
Die größten Fehler bei Clusteranalysen entstehen oft nicht im Algorithmus, sondern in der Interpretation. Ein Cluster ist keine objektiv vorhandene Schublade in der Realität. Es ist das Ergebnis einer konkreten Kombination aus Daten, Variablenauswahl, Skalierung, Distanzmaß und Algorithmus. Schon eine andere Skalierung oder das Hinzufügen einer hoch korrelierten Variable kann Grenzen verschieben.
Deshalb sollte eine belastbare Analyse mindestens drei Arten von Prüfung enthalten:
- Interne Validierung: Wie kompakt und getrennt sind die Cluster? Silhouette, Within-Cluster-Sum-of-Squares und Gap-Statistik liefern Anhaltspunkte.
- Stabilitätsprüfung: Bleiben die Gruppen ähnlich, wenn Stichproben leicht verändert, Ausreißer entfernt oder Startwerte gewechselt werden? Eine Lösung, die bei kleinen Änderungen zusammenbricht, sollte nicht zur Steuerungslogik werden.
- Fachliche Validierung: Sind die Cluster inhaltlich plausibel, zeitlich einigermaßen stabil und mit unterschiedlichen Maßnahmen verknüpfbar? Ohne diese Prüfung bleibt die Lösung ein mathematisches Muster ohne Managementwert.
Die Praxis zeigt, dass die Clusteranalyse beispielsweise zur Analyse von Risiken im Kontext von Supply-Chain-Prozessen praktisch eingesetzt werden kann. Hallikas et al. nutzten Clusteranalyse beispielsweise zur risikobasierten Klassifikation von Lieferantenbeziehungen und verbanden die resultierenden Typen mit unterschiedlichen Formen des Risikomanagements und organisationalen Lernens [vgl. Hallikas / Puumalainen / Vesterinen / Virolainen 2005]. Das bedeutet nicht, dass ein heutiges Unternehmen deren konkrete Typologie übernehmen sollte – wohl aber, dass die Grundidee einer datenbasierten Segmentierung wissenschaftlich und auch in der Praxis anschlussfähig ist.
Die unterschätzte Frage: Was bedeutet "ähnlich"?
Im Risikomanagement ist Ähnlichkeit nie rein technisch. Wenn alle sechs Variablen nach Standardisierung gleich gewichtet in die Distanz eingehen, lautet die implizite Annahme: Eine Standardabweichung mehr Cyber-Exposure ist für die Ähnlichkeitsberechnung genauso bedeutsam wie eine Standardabweichung mehr Ausfallwahrscheinlichkeit. Das kann sinnvoll sein – muss es aber nicht.
Deshalb sollten Gewichte nicht leichtfertig eingeführt werden, aber ihre Abwesenheit ist ebenfalls eine Gewichtungsentscheidung. Wer drei Variablen zur Lieferperformance und nur eine zum Cyberrisiko verwendet, gewichtet Lieferperformance indirekt stärker. Ein sauberer Modellierungsprozess dokumentiert daher, welche Risikodimensionen vertreten sind, welche Variablen redundant sind und ob Transformationen vorgenommen wurden.
Ein weiteres Problem ist die sogenannte "Curse of Dimensionality". Mit vielen Dimensionen werden Abstände tendenziell weniger trennscharf, und irrelevante Variablen können echte Struktur überdecken. Mehr Datenfelder bedeuten deshalb nicht automatisch mehr Erkenntnis. Häufig ist eine kleinere, fachlich gut begründete Merkmalsmenge besser als ein unkritisch zusammengeschütteter Data Lake.
Von Diagnostic zu Predictive Analytics
Die Clusteranalyse selbst beantwortet vor allem die Frage: "Welche Strukturen und Risikotypen finden wir in den vorhandenen Daten?" Sie ist damit noch keine Prognosemethode. Der Schritt zu Predictive Analytics beginnt erst, wenn zukünftige Zielgrößen modelliert werden – zum Beispiel Lieferausfall innerhalb der nächsten zwölf Monate, Schadenhöhe oder Dauer einer Produktionsunterbrechung.
Cluster können dabei trotzdem nützlich sein. Man kann prüfen, ob die ermittelten Gruppen unterschiedliche zukünftige Ausfallraten zeigen. Die Clusterzugehörigkeit kann als zusätzliche erklärende Variable in ein Prognosemodell eingehen. Oder es werden getrennte Prognosemodelle für strukturell verschiedene Lieferantengruppen entwickelt. Methodisch wichtig ist dann die Trennung von Training und Test: Skalierung und Clusterzentren dürfen nur aus den Trainingsdaten gelernt werden; Testdaten werden anschließend mit denselben Transformationen und Zentren zugeordnet. Sonst schleicht sich Datenleckage in die Prognose ein.
Genau hier wird die Logik von Data Analytics im Risikomanagement deutlich: Descriptive Analytics beschreibt, Diagnostic Analytics strukturiert und erklärt Muster, Predictive Analytics richtet den Blick auf zukünftige Entwicklungen. Die Methoden sind keine isolierten Inseln, sondern Bausteine einer analytischen Kette. Daher haben wir unser Buch "Data Analytics im Risikomanagement" entsprechend von der deskriptiven über die diagnostische bis hin zur prädiktiven Analyse aufgebaut.
Fazit: Gute Cluster entstehen nicht durch Knopfdruck
Clusteranalyse kann aus einer unübersichtlichen Risikolandschaft eine handhabbare Typologie machen. Ihr eigentlicher Wert liegt nicht darin, 300 Punkte hübsch einzufärben, sondern darin, unterschiedliche Muster zu erkennen, die unterschiedliche Managementreaktionen benötigen. Ein strategischer Engpass ist etwas anderes als ein finanziell instabiler Lieferant - auch wenn beide in einer klassischen Ampellogik "rot" wären.
Die Methode verlangt jedoch Disziplin. Daten müssen sinnvoll ausgewählt und skaliert, Distanz und Verfahren begründet, die Clusterzahl geprüft und die Lösung auf Stabilität und fachliche Plausibilität getestet werden. Erst danach dürfen aus mathematischen Gruppen betriebswirtschaftliche Risikotypen werden.
Vielleicht ist das die wichtigste Botschaft: Die Clusteranalyse nimmt dem Risikomanager nicht das Denken ab. Sie verschiebt es an die richtige Stelle – weg vom Sortieren einzelner Ampeln und hin zur Frage, welche Risikomuster tatsächlich hinter den Daten stecken.
Quellenverzeichnis und weiterführende Literaturhinweise
- Hallikas, Jukka / Puumalainen, Kaisu / Vesterinen, Toni / Virolainen, Veli-Matti (2005): Risk-based classification of supplier relationships. Journal of Purchasing and Supply Management, 11(2-3), S. 72-82. DOI: 10.1016/j.pursup.2005.10.005.
- MacQueen, James B. (1967): Some Methods for Classification and Analysis of Multivariate Observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, Vol. 1, S. 281-297.
- Romeike, Frank / Wieczorek, Gabriele (2026): Data Analytics im Risikomanagement - Descriptive Analytics - Diagnostic Analytics - Predictive Analytics. Springer Gabler, Wiesbaden. Clusteranalyse: S. 151-235. DOI: 10.1007/978-3-658-48843-7.
- Rousseeuw, Peter J. (1987): Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, S. 53-65. DOI: 10.1016/0377-0427(87)90125-7.
- Tibshirani, Robert / Walther, Guenther / Hastie, Trevor (2001): Estimating the Number of Clusters in a Data Set Via the Gap Statistic. Journal of the Royal Statistical Society: Series B, 63(2), S. 411-423. DOI: 10.1111/1467-9868.00293.
- Ward, Joe H. Jr. (1963): Hierarchical Grouping to Optimize an Objective Function. Journal of the American Statistical Association, 58(301), S. 236-244. DOI: 10.1080/01621459.1963.10500845.